2026
StepAudio 3 Realtime Technical Report
Bin Lin, Bo Zhao, Boyang Zhang, …, Jialong Xue, …
arXiv preprint arXiv:2609.14005 2026
StepAudio 3 Realtime integrates audio understanding, full-duplex conversation, parallel reasoning and speech generation, and voice-based task execution. It supports natural turn-taking and interruptions, with asynchronous tool use that keeps conversations flowing. My contributions: primarily full-duplex interaction and Voice Agent capabilities.
StepAudio 3 Realtime Technical Report
Bin Lin, Bo Zhao, Boyang Zhang, …, Jialong Xue, …
arXiv preprint arXiv:2609.14005 2026
StepAudio 3 Realtime integrates audio understanding, full-duplex conversation, parallel reasoning and speech generation, and voice-based task execution. It supports natural turn-taking and interruptions, with asynchronous tool use that keeps conversations flowing. My contributions: primarily full-duplex interaction and Voice Agent capabilities.
Unified Spatiotemporal Token Compression for Video-LLMs at Ultra-Low Retention
Junhao Du*, Jialong Xue*, Anqi Li, Jincheng Dai, Guo Lu
IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 2026
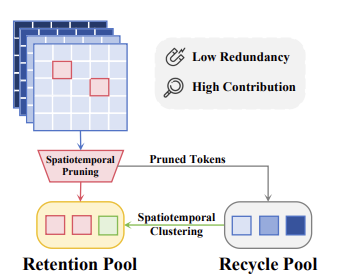
We formulate token compression for Video-LLMs as a unified spatiotemporal allocation problem under a global retention budget. The method preserves strong video understanding performance at ultra-low token retention without retraining.
Unified Spatiotemporal Token Compression for Video-LLMs at Ultra-Low Retention
Junhao Du*, Jialong Xue*, Anqi Li, Jincheng Dai, Guo Lu
IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 2026
We formulate token compression for Video-LLMs as a unified spatiotemporal allocation problem under a global retention budget. The method preserves strong video understanding performance at ultra-low token retention without retraining.